Claude Code 토큰 다이어트를 위한 최적화 핵심 전략
Claude Code로 복잡한 로직을 구현하다 보면 '사용 한도 도달' 메시지를 마주할 때가 있습니다.
이는 비용의 문제일 뿐만 아니라 작업 중인 개발 흐름을 끊는 것이기도 하고, 이 문제의 중심에는 토큰(Token)이 있습니다.
Anthropic의 요금제는 크게 두 가지로 나뉩니다.
토큰 단위로 과금되는 API 요금제와, 월 정액으로 사용량이 할당되는 구독 요금제입니다.
API 요금제는 입력 토큰보다 출력 토큰의 가격이 5배 비쌉니다.
2026년 10월 기준 공식 API 가격은 다음과 같습니다.
| 모델 | 입력 (100만 토큰) | 출력 (100만 토큰) |
|---|---|---|
| Claude Fable 5.1 / 5 | $10 | $50 |
| Claude Opus 5.5 | $4 | $20 |
| Claude Opus 5 / 4.8 / 4.7 | $5 | $25 |
| Claude Sonnet 5.5 / 5 | $2 | $10 |
| Claude Haiku 5.5 | $0.10 (프롬프트 10만 토큰 초과 시 $0.50) |
$0.50 (프롬프트 10만 토큰 초과 시 $2.50) |
2026년 9월 22일에 출시된 Opus 5.5는 Opus 5보다 입력과 출력 단가가 20% 낮고, 캐시에서 읽는 입력의 단가는 60% 낮습니다.
Anthropic은 기본 설정으로 사용하면 Opus 5보다 약 40% 적은 비용이 든다고 발표했으며, Claude Code v2.1.280부터는 모든 플랜과 API의 기본 모델도 Opus 5.5입니다.
9월 28일에 출시된 Sonnet 5.5는 Sonnet 5와 단가가 같지만, Sonnet 5보다 출력이 30% 이상 빠르고 같은 작업을 더 적은 토큰으로 처리해서 작업당 비용이 최대 30% 낮다고 발표되었습니다.
10월 7일에 출시된 Haiku 5.5는 프롬프트가 10만 토큰 이하인 요청에서 Haiku 4.5보다 단가가 90% 낮고, 10만 토큰을 넘는 요청에는 다섯 배 높은 단가가 적용됩니다.
같은 날 Sonnet 5.5의 캐시 Read 단가도 100만 토큰당 $0.20에서 $0.10으로 절반이 되었습니다.
그리고 Claude 4.7 이후 모델은 새 토크나이저(Tokenizer)를 사용합니다.
Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable을 포함한 최신 모델이 모두 여기에 해당하며, 같은 텍스트를 약 30% 더 많은 토큰으로 나눕니다.
정가가 같아도 실제 청구액은 오를 수 있어서, 이전 세대와 비교할 때는 이 점을 감안해야 합니다.
구독 요금제의 사용량은 Claude 앱(채팅과 Cowork)과 Claude Code가 함께 공유합니다.
Claude Code는 Pro 플랜부터 사용할 수 있으며, 해당하는 플랜은 다음과 같습니다.
| 플랜 | 월 / 연 요금 | 사용량 |
|---|---|---|
| Pro | $20 / $17 | Claude Code를 쓸 수 있는 최소 플랜 |
| Max | $100 ~ $200 | Pro 대비 5배 또는 20배 |
| Team | 표준 시트 $25 / $20 프리미엄 시트 $125 / $100 |
시트 등급에 따라 배정 |
| Enterprise | 시트당 $20 ~ + 사용량 |
관리자가 한도 설정 |
구독 요금제에서도 어떤 모델을 사용하느냐가 쿼터 소진 속도에 큰 영향을 줍니다.
특히 Fable은 Pro 플랜에서는 사용량 크레딧으로만 청구되고, Max 플랜에서는 주간 한도의 50%까지 사용할 수 있습니다.
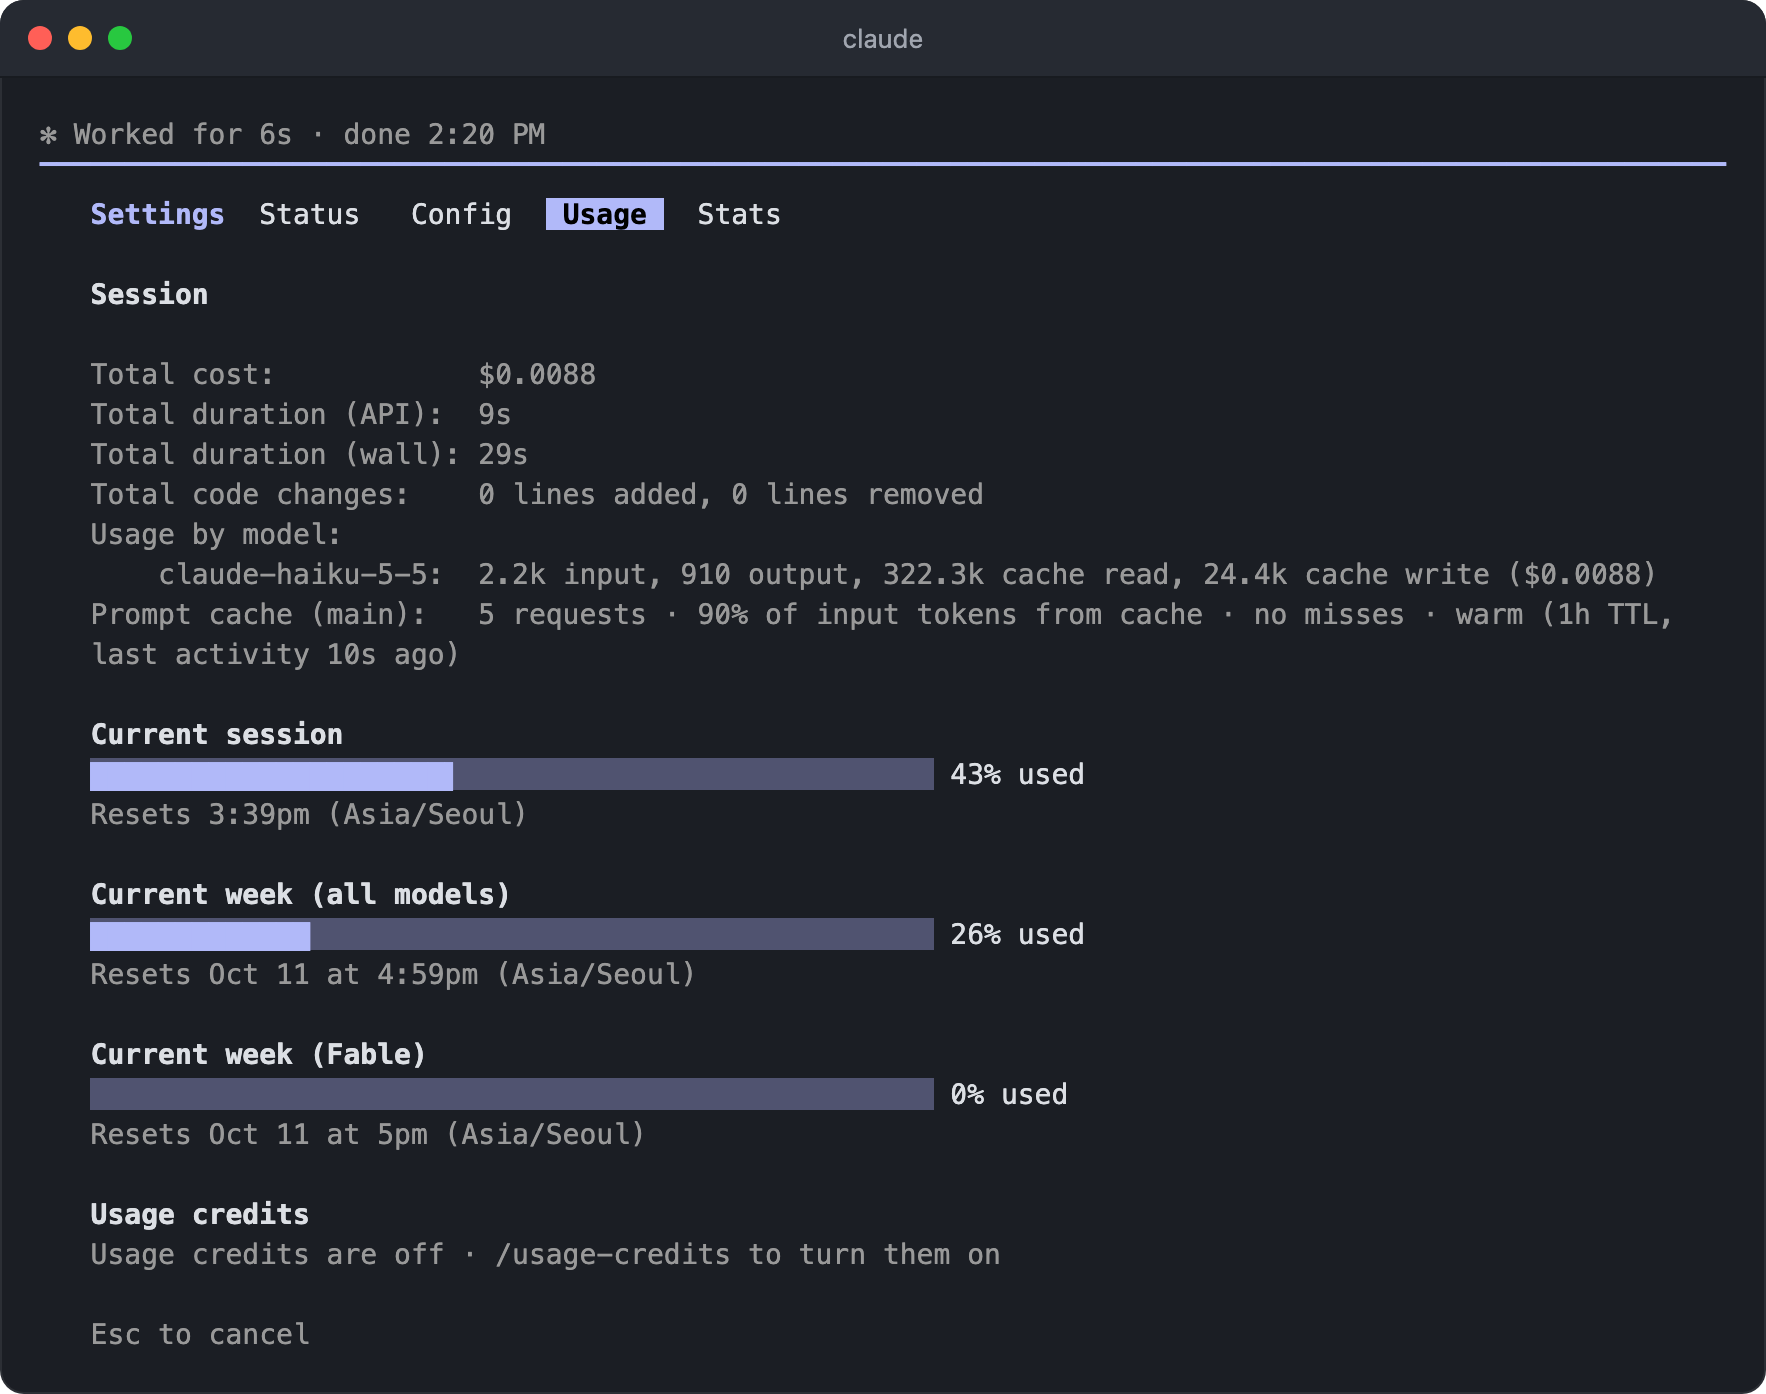
현재 잔여 쿼터와 세션의 토큰 사용량은 /usage 명령으로 확인할 수 있고, 같은 화면의 Stats 탭(/stats)에서는 활동 통계를 볼 수 있습니다.
Pro, Max, Team, Enterprise 플랜에서는 최근 사용량을 스킬, 서브에이전트, 플러그인, MCP 서버별 비율로 나눠 보여 주고, 긴 컨텍스트나 캐시 미스처럼 사용량의 10% 이상을 차지하는 동작이 있으면 줄이는 방법과 함께 알려 줍니다.
요금은 토큰 단위로 청구되지만, 실제로 지불하는 것은 추론(Inference) 시간입니다.
GPU가 모델을 실행하면서 토큰을 처리하는 데 걸린 시간이 비용이고, 구독 요금제에서는 가격이 보이지 않을 뿐 같은 요청이 사용량 한도를 소진합니다.
토큰 하나를 처리하는 시간은 어떤 모델을 사용하는지, 입력 토큰인지 출력 토큰인지, 그리고 캐시되어 있는지 세 가지가 결정합니다.
출력 토큰이 입력보다 비싼 이유도 여기에 있습니다.
요청 하나는 두 단계로 처리됩니다.
프리필(Prefill) 단계에서 모델은 시스템 프롬프트, CLAUDE.md, 사용자 메시지, 그리고 지금까지 대화에 쌓인 파일과 명령 출력을 읽습니다.
이것이 입력 토큰이고, 많은 양을 한꺼번에 병렬로 처리할 수 있습니다.
디코드(Decode) 단계에서는 사고 과정, 도구 호출, 화면에 보이는 답변을 한 토큰씩 순서대로 생성합니다.
200 토큰짜리 응답은 모델을 200번 연달아 실행한 결과라서 GPU를 훨씬 오래 점유하고, 그래서 출력 토큰의 단가가 입력의 5배입니다.
모델은 이전 요청을 기억하지 않기 때문에, 매 요청마다 대화 전체를 처음부터 다시 읽습니다.
이것이 뒤에서 다룰 컨텍스트 관리와 프롬프트 캐싱의 출발점입니다.
토큰 관리는 비용 절감 외에도 생산성과 답변 품질에 직접 영향을 줍니다.
컨텍스트(Context)가 지나치게 커지면 Claude의 추론 품질이 떨어지고 환각(Hallucination)이 발생할 가능성이 높아집니다.
# 모델 분담
모든 작업에 Opus를 사용하는 것은 비효율적입니다.
그런데 Claude Code v2.1.280부터 Pro를 포함한 모든 플랜의 기본 모델이 Opus 5.5라서, 모델을 따로 고르지 않으면 모든 작업을 Opus가 처리합니다.
Opus 5.5는 이전 Opus보다 저렴해졌지만 여전히 Sonnet 5.5보다 단가가 두 배 높고, Anthropic은 대부분의 일반적인 코딩 작업에는 Sonnet이면 충분하고 Opus는 고차원 설계나 복잡한 디버깅에 남겨 두도록 권장합니다.
Sonnet 5.5는 범위가 분명한 일상 작업과 버그 수정에 강하며, Anthropic의 비교에서는 여러 벤치마크에서 low나 medium 노력 수준만으로 Sonnet 5의 최고 점수를 약 10분의 1 비용으로 넘었습니다.
단순 작업이나 서브에이전트는 Haiku로 분담하는 것이 유리합니다.
Haiku 5.5는 Haiku 4.5보다 평균 약 75% 저렴하고, Anthropic은 요약, 압축, 분류 같은 반복 작업과 코딩 작업의 서브에이전트에 적합하다고 소개합니다.
다만 복잡한 에이전트 코딩에는 여전히 Sonnet 5.5와 Opus 5.5가 낫다고 덧붙였습니다.
성능과 비용을 함께 고려할 수 있는 두 가지 방법이 있습니다.
opusplan 모델은 작업을 '계획'과 '실행'으로 자동 분리합니다.
추론 성능이 높은 Opus가 설계 단계(Planning)를 담당하고, 실제 코드를 작성하는 실행 단계(Execution)에서는 자동으로 Sonnet으로 전환됩니다.
모델이 바뀌어도 대화 컨텍스트는 유지되므로, Sonnet이 Opus가 수립한 계획을 그대로 보고 구현합니다.
다만 플랜 모드를 오갈 때마다 모델이 바뀌는 것이라서, 그때마다 프롬프트 캐시가 초기화된다는 점은 감안해야 합니다.
다음과 같이 /model 명령어를 사용합니다.
1/model opusplan
/advisor는 실제 작업은 빠르고 저렴한 Executor 모델(Sonnet, Haiku)이 맡고, 어려운 판단이 필요한 순간에만 더 고성능인 Advisor 모델(일반적으로 Opus)에게 자문을 구하는 방식입니다.
사용자가 매번 수동으로 호출하는 게 아니라, Executor 모델이 복잡한 결정, 반복 에러, 작업 완료 체크포인트에 도달하면 스스로 판단해 Advisor 모델을 호출합니다.
Advisor는 Executor 모델보다 성능이 같거나 높아야 해서, 기본 모델인 Opus 5.5에는 Opus 5 이후 모델이나 Fable만 Advisor로 지정할 수 있습니다.
비용을 줄이려는 목적이라면 먼저 /model로 Executor 모델을 Sonnet으로 바꾼 다음 /advisor 명령어를 사용합니다.
12/model sonnet /advisor opus
비용을 더 낮추려면 /model haiku로 Haiku 5.5를 Executor로 지정할 수도 있습니다(Claude Code v2.1.293 이상).
Haiku만 사용할 때보다는 비용이 늘지만, 주 모델을 Sonnet이나 Opus로 바꾸는 것보다는 적게 들면서 어려운 판단이 필요한 지점에서 Opus의 자문을 받을 수 있습니다.
Advisor를 호출할 때마다 Advisor 모델은 대화 전체를 캐시 없이 새로 읽고, 그 토큰은 Advisor 모델의 단가로 청구되거나 플랜 사용량에 포함됩니다.
그래도 매 턴이 아니라 결정이 필요한 지점에서만 호출되므로, 처음부터 끝까지 강한 모델로 작업하는 것보다 비용이 적게 듭니다.
세션 도중에 /advisor를 켜거나 꺼도 Executor 모델의 프롬프트 캐시는 유지됩니다.
위 두 가지 방법은, 모든 작업을 Opus로만 처리하는 것보다 비용 효율이 좋다고 알려져 있습니다.
프로젝트 성격에 따라 opusplan은 단일 세션 안에서 역할을 나누는 용도, advisor는 장시간 세션에서 보조 의견을 받는 용도로 구분해 쓰면 됩니다.
반대로 비용이 늘어나는 선택지도 있습니다./fast는 Opus의 출력 속도를 최대 2.5배까지 높이는 리서치 프리뷰 기능인데, 100만 토큰당 가격이 Opus 5.5는 입력 $8, 출력 $40, Opus 5와 Opus 4.8은 입력 $10, 출력 $50으로 기본 가격의 두 배입니다.
구독 요금제에서는 플랜 사용량이 아니라 사용량 크레딧으로만 청구되므로 /usage-credits에서 크레딧 사용을 먼저 활성화해야 합니다.
켜는 순간 캐시가 한 번 무효화되니, 대화가 길어지기 전인 세션 초반에 켜는 것이 좋습니다.
그리고 켜 둔 상태는 기본적으로 다음 세션까지 유지되므로, 빠른 응답이 필요한 작업이 끝나면 /fast로 다시 끄세요.
# 노력 수준 조절
Claude의 최신 모델은 답변을 생성하기 전에 필요한 만큼 사고하는 적응형 추론(Adaptive Reasoning)을 사용합니다.
여기서 간과하기 쉬운 점은, 이 사고 과정도 출력 토큰으로 과금된다는 것입니다.
간단한 파일 수정 요청이라도 내부 추론으로 수천에서 수만 토큰이 소모될 수 있으며, 방치하면 몇 번의 대화만으로도 특히 Pro 요금제에서는 세션 한도가 소진될 수 있습니다.
이를 통제하는 도구가 /effort 명령어입니다.
노력 수준(Effort)은 사고 시간만 정하는 설정이 아닙니다.
Anthropic의 블로그에 따르면 노력 수준은 Claude가 한 요청에 들이는 작업량 전체를 정합니다.
파일을 몇 개나 읽는지, 결과를 얼마나 검증하는지, 사용자에게 확인하기 전까지 여러 단계의 작업을 어디까지 진행하는지가 모두 여기에 포함됩니다.
노력 수준이 낮으면 Claude는 스스로 찾아보는 데 토큰을 사용하기보다 사용자에게 필요한 정보를 묻는 쪽을 택합니다.
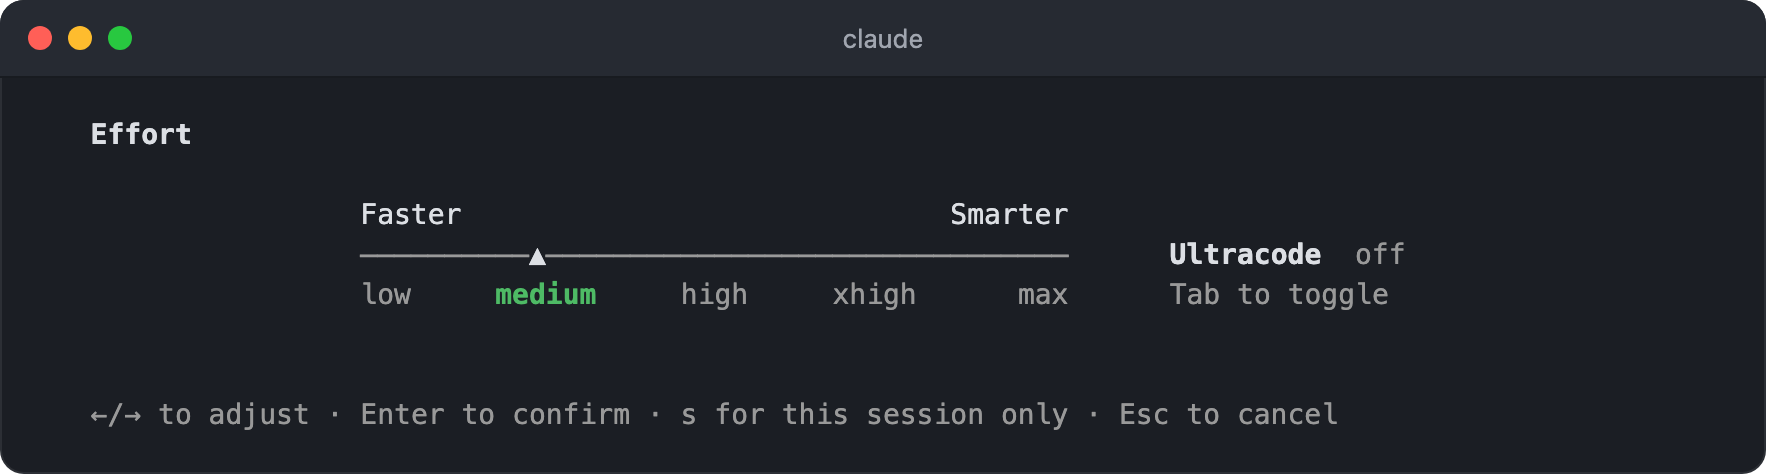
low: 짧고 범위가 좁은 작업, 지연 시간에 민감한 작업medium: 지능을 조금 양보하더라도 토큰 사용량을 줄이려는 작업, Opus 5.5, Sonnet 5.5, Haiku 5.5의 기본값high: 토큰 사용량과 지능의 균형점, Opus 5.5, Sonnet 5.5, Haiku 5.5, Opus 4.7을 제외한 모델의 기본값xhigh: 더 깊은 추론, 그만큼 토큰도 더 사용, Opus 4.7의 기본값max: 가장 깊은 추론. 과잉 추론 경향이 있어 모든 작업에 유리하지는 않고, 환경 변수로 지정하지 않는 한 현재 세션에만 적용됩니다.
Anthropic은 대부분의 작업에서 모델의 기본값을 그대로 사용하고, 노력 수준은 작업마다 바꾸기보다 자신이 주로 하는 일의 성격에 맞춰 정하는 설정으로 다루라고 권합니다.
기본 모델인 Opus 5.5와 Sonnet 5.5, Haiku 5.5는 이미 medium으로 시작하므로 단순 작업이 많은 세션이라면 low까지 낮출 수 있고, Fable처럼 high로 시작하는 모델은 /effort medium 또는 low로 낮추는 것이 효과적입니다.
Haiku 5.5는 노력 수준을 지원하는 첫 Haiku 모델이며, 이전 Haiku 4.5에서는 노력 수준을 바꿀 수 없습니다.
결과가 틀렸을 때 무엇을 바꿔야 하는지도 구분할 수 있습니다.
Claude가 필요한 컨텍스트를 모두 가진 채 충분히 시도했는데도 틀렸다면 더 큰 모델이 필요하다는 신호입니다.
반면 파일을 건너뛰거나, 테스트를 실행하지 않거나, 리팩터링을 중간에 멈춰서 틀렸다면 노력 수준을 올려야 한다는 신호입니다.
다만 노력 수준을 올리기 전에, 프롬프트가 모호하지 않은지와 CLAUDE.md, 작업 범위가 적절한지부터 확인하는 것이 먼저입니다.
/effort 화면에는 Tab으로 켜고 끄는 ultracode 토글도 있습니다.
모델의 노력 수준이 아니라 Claude Code의 설정으로, 켜 두면 Claude가 규모 있는 작업마다 워크플로우를 구성해서 여러 서브에이전트로 처리합니다.
v2.1.284부터는 노력 수준을 xhigh로 올리지 않고 현재 노력 수준 그대로 켜지지만, 작업 하나가 여러 워크플로우로 이어질 수 있어서 같은 작업을 끈 상태로 처리할 때보다 토큰을 훨씬 많이 사용하고 사용 한도에도 더 빨리 도달합니다.
토큰을 아끼려는 세션에서는 켜지 않는 것이 좋습니다.
한 번만 깊게 생각하게 하고 싶다면 프롬프트 안에 ultrathink를 포함하면 됩니다.
API로 전달되는 노력 수준은 그대로 두고 해당 턴에만 더 깊이 추론하라는 지시를 덧붙이는 방식입니다.
세션 도중에 노력 수준을 바꾸면 대부분의 모델에서 프롬프트 캐시가 통째로 무효화되고, 캐시가 살아 있는 동안에는 Claude Code가 바꾸기 전에 확인을 요청합니다.
예외는 Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1로, API 키나 Claude 구독으로 연결했다면 노력 수준을 바꿔도 캐시가 유지됩니다.
그 밖의 모델에서는 모델과 마찬가지로 세션을 시작할 때 정해 두고, 작업 중간에는 되도록 바꾸지 마세요.
/effort 화면에서 Enter로 확정하거나 /effort medium처럼 입력한 단계는 모델별로 저장되어 다음 세션의 기본값이 됩니다.
현재 세션에만 적용하려면 Enter 대신 s를 누릅니다./model로 고른 모델도 다음 세션의 기본값으로 저장됩니다.
지난 세션에서 어려운 작업 때문에 올려 둔 설정이 오늘의 단순 작업에도 그대로 적용될 수 있으니, 새 세션을 시작하면 /model과 /effort를 한 번씩 실행해 현재 설정을 확인하세요.
설정은 우연이 아니라 의도한 선택이어야 합니다.
/effort auto로 현재 모델에 저장한 단계를 지우고 모델 기본값으로 되돌릴 수 있고, CLAUDE_CODE_EFFORT_LEVEL 환경 변수로 영구 오버라이드도 가능합니다.
12345{ "env": { "CLAUDE_CODE_EFFORT_LEVEL": "medium" } }
확장 사고를 아예 끄는 방법도 있습니다.Option+T(Windows와 Linux는 Alt+T)로 현재 세션에서 켜고 끄거나, 단순 작업만 처리할 세션이라면 MAX_THINKING_TOKENS=0 claude로 실행합니다.
다만 Opus 5.5, Sonnet 5.5, Haiku 5.5와 Fable 모델은 확장 사고를 끌 수 없어서 이 설정이 적용되지 않으므로, 이 모델들에서는 노력 수준으로만 조절합니다.
# 컨텍스트 관리
대화가 길어질수록 AI의 집중력이 흐려지는 현상을 컨텍스트 롯(Context Rot)이라 부릅니다.
여기에 비용 관점을 하나 더해야 합니다.
Claude Code에서 대화에 한 번 들어온 것은 한 번만 전송되지 않습니다.
Claude가 읽은 파일과 실행한 명령의 출력은 세션이 끝날 때까지 이후 모든 턴에서 다시 전송됩니다.
캐시 덕분에 재전송 비용은 낮지만 0은 아니고, 모델이 매 턴 그것까지 포함해서 추론해야 하므로 품질에도 영향을 줍니다.
그래서 세션의 비용은 컨텍스트에 몇 토큰이 들어가는지, 그 토큰이 몇 턴 동안 남아 있는지, 그리고 동시에 몇 개의 컨텍스트를 실행하는지로 정리됩니다.
긴 세션 하나는 같은 작업을 짧은 세션 여러 개로 나눈 것보다 비쌉니다.
40번째 질문은 앞의 39턴을 전부 다시 읽기 때문입니다.
따라서 세션의 컨텍스트는 짧게, 지금 하는 작업과 관련된 것만 남도록 유지해야 합니다.
# 고정 비용 관리
첫 메시지를 보내기 전부터 컨텍스트에는 이미 도구 정의, 시스템 프롬프트, CLAUDE.md, 스킬 목록이 실려 있습니다.
매 세션마다 자동으로 로드되는 이 고정 비용 요소부터 확인합니다.
CLAUDE.md는 세션 시작 시 자동으로 로드되어 이후 모든 대화 턴에 포함되는 프로젝트 지침 파일입니다.
매 턴마다 전송되는 고정 비용이므로, 파일은 2천 토큰 이내로 소비하도록 작성하는 것이 권장됩니다.
공식 문서는 200줄 이내를 기준으로 제시하지만, 한글 기준으로는 50줄에서 100줄 이내가 적당합니다.
그래서 Claude가 스스로 추측할 수 있는 일반적인 컨벤션은 빼고, 오직 프로젝트 고유의 규칙과 맥락만 남기는 것이 핵심입니다.
만약 상세 문서가 필요하면 별도 파일이나 스킬로 분리하고, CLAUDE.md에는 참조 경로만 명시해 두는 전략이 효과적입니다.
참고로 CLAUDE.md는 세션이 시작될 때 한 번 읽어 들이므로, 세션 도중에 파일을 고쳐도 그 세션에는 반영되지 않습니다./clear나 /compact를 실행하거나 세션을 다시 시작해야 새 내용이 적용됩니다.
스킬(Skill)에도 고정 비용이 있습니다.
스킬의 본문은 호출할 때만 불러오지만, 스킬의 이름과 설명 목록은 사용 여부와 관계없이 매 턴 컨텍스트에 포함됩니다./skill-doctor 명령을 실행하면 스킬마다 차지하는 컨텍스트 크기와 사용 빈도를 보여 주고, 한 번도 호출되지 않은 스킬과 그 스킬을 끄는 위치를 알려 줍니다(Claude Code v2.1.252 이상).
컨텍스트 비용이 큰 스킬부터 정리하고, /이름으로 직접 호출할 때만 쓰는 스킬은 프론트매터에 disable-model-invocation: true를 지정하면 목록에서도 빠집니다.
MCP 도구도 정비해야 합니다.
기존에는 MCP 도구의 전체 정의가 처음부터 컨텍스트에 올라갔었기 때문에 사용하지 않는 MCP는 수동으로 비활성화가 필요했지만, 지금은 도구 검색(Tool Search)이 기본으로 동작하기 때문에 서버 지침과 도구 이름 정도만 들어가고 실제로 그 도구를 사용할 때 정의를 불러옵니다.
그래도 MCP 서버가 많아지면 이름 목록만으로도 컨텍스트를 차지하고, 도구 검색이 동작하지 않는 환경에서는 정의 전체가 그대로 올라가게 되니 적당한 관리가 필요합니다./mcp 명령어로 설정된 서버 목록을 확인하고, 당장 사용하지 않는 MCP 서버는 일단 비활성화한 뒤 필요할 때 다시 활성화해서 사용하세요.
Anthropic의 공식 가이드는 가능하면 MCP보다 CLI 도구를 우선 사용할 것을 권합니다.gh, aws, gcloud, sentry-cli 같은 CLI 도구는 도구 정의 오버헤드가 없고 필요한 출력만 반환하기 때문에 컨텍스트 효율이 훨씬 좋습니다.
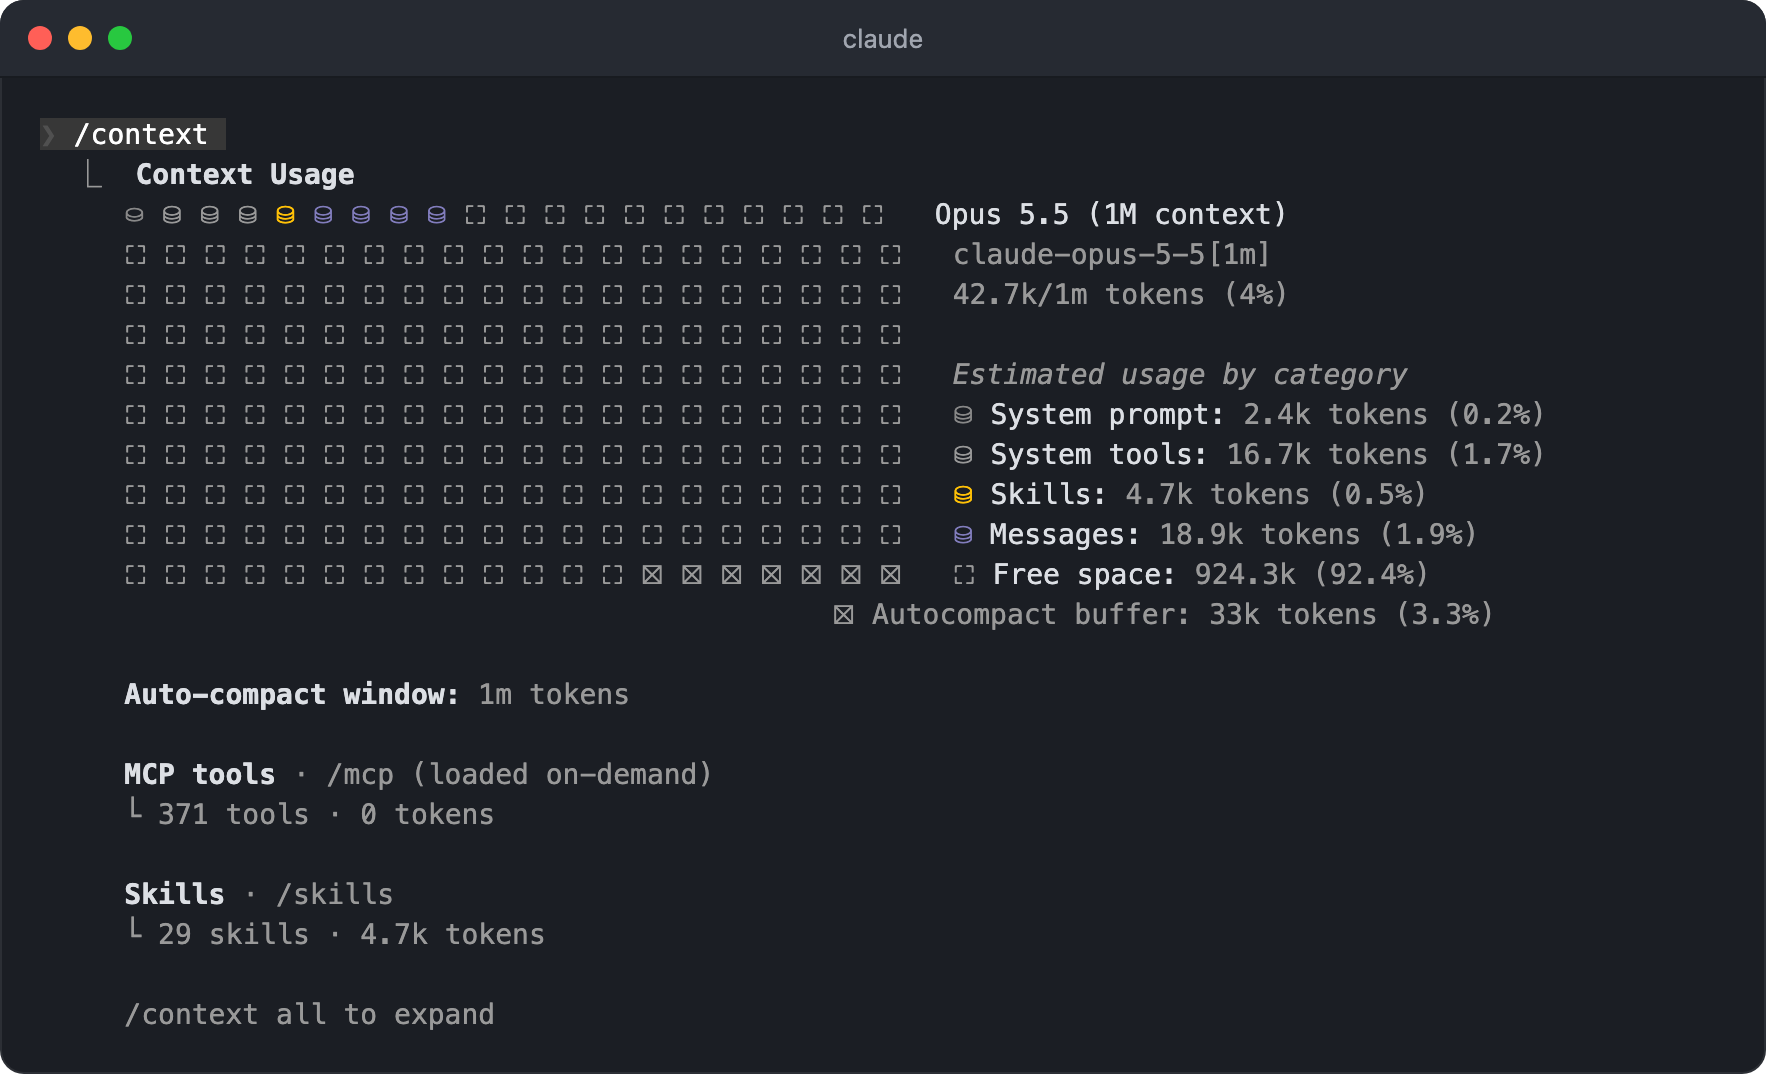
새 세션에서 아무것도 입력하기 전에 /context 명령을 실행하면 시작 시점에 무엇이 얼마나 실려 있는지 항목별로 볼 수 있습니다.
각 요소가 몇 퍼센트를 차지하는지 실제 수치를 확인하는 습관을 들이면, 감이 아닌 데이터를 근거로 최적화할 수 있습니다.
# 파일과 명령 출력
세션을 시작한 뒤 컨텍스트에 추가되는 것은 대부분 도구 결과입니다.
사용자가 입력하는 메시지는 몇 줄이지만, Claude가 읽는 파일 하나는 수천 토큰이고 명령 하나의 출력도 그만큼 길어질 수 있습니다.
Claude가 얼마나 많이 읽는지는 스스로 알아내야 하는 양에 달려 있습니다.
"테스트가 실패해"처럼 요청하면 어떤 테스트인지부터 찾아야 하므로 검색을 몇 번 실행하고 관련 있어 보이는 파일을 여러 개 열어 보게 되고, 그 결과는 쓸모가 없어진 뒤에도 세션 끝까지 컨텍스트에 남습니다.
"utils.test.ts의 실패하는 테스트를 고쳐 줘"라고 파일을 지정하면 검색 과정이 사라지고 Read 호출 한 번만 남습니다.@로 파일을 멘션(Mention)하면 그 한 번마저 사라집니다.
1@utils.test.ts 의 실패하는 테스트를 고쳐 줘
Claude Code는 멘션한 파일을 전송 전에 메시지에 첨부하므로, 첫 요청부터 파일이 포함되어 있고 모델이 파일을 읽어 달라고 요청하는 턴이 생략됩니다.
파일이 차지하는 컨텍스트 크기는 어느 쪽이든 같으므로 멘션은 한 대화에 한 번이면 충분합니다.
같은 파일을 이후 턴에서 다시 멘션하면 사본이 하나 더 첨부되므로, 두 번째부터는 파일명만 입력합니다.
TypeScript처럼 타입이 있는 언어를 사용한다면 코드 인텔리전스 플러그인을 설치하는 것도 방법입니다.
텍스트로 검색한 뒤 후보 파일을 여러 개 읽는 대신, 정의로 이동하는 호출 한 번으로 필요한 위치를 찾기 때문에 불필요한 파일 읽기가 줄어듭니다.
명령 출력도 파일과 같은 방식으로 컨텍스트에 남습니다.
테스트, 빌드, git log를 실행할 때마다 그 출력이 대화에 추가되고 파일과 같은 턴 수만큼 남아 있습니다.
30,000자를 넘는 큰 출력은 Claude Code가 파일로 저장하고 앞부분 2,000자 정도의 미리보기와 경로만 대화에 넣기 때문에 오히려 문제가 되지 않습니다.
이 기준은 bashOutputMaxChars 설정으로 최대 128,000자까지 조절합니다(Claude Code v2.1.261 이상).
실패한 명령은 기준이 약 10,000자이고, 넘으면 파일로 저장하지 않고 앞뒤 일부만 대화에 넣습니다.
문제는 그 아래 크기입니다.
통과한 테스트 400개를 한 줄씩 출력하는 테스트 러너는 기준에 걸리지 않고, 그 400줄이 남은 모든 턴에 포함됩니다.
Claude가 출력을 줄이는 플래그나 tail을 스스로 추가하는 경우도 많지만, 매일 사용하는 명령 두세 개는 출력을 줄이는 옵션까지 포함한 형태로 CLAUDE.md에 작성하는 것이 확실합니다.
1- 단일 테스트 파일 실행: `npx vitest run src/utils.test.ts --reporter=dot`
공식 문서에는 테스트 출력에서 실패한 항목만 남기도록 명령을 고쳐 쓰는 PreToolUse 훅(Hook) 예제도 있습니다.
# 대화 정리
컨텍스트에 들어온 것이 얼마나 오래 남는지는 세션을 어떻게 나누느냐에 달려 있습니다.
한 작업의 컨텍스트를 다음 작업까지 가져가지 않도록, 새 작업을 시작할 때는 /clear, 같은 작업의 앞부분이 끝났을 때는 /compact를 사용합니다.
/clear는 대화를 완전히 비웁니다.
오전에 하던 글 정리를 끝내고 전혀 다른 작업을 시작한다면 이전 대화를 이어갈 이유가 없으므로 비우고 새로 시작합니다.
비우는 데는 비용이 들지 않으며, 나중에 그 세션으로 돌아올 일이 있다면 /clear 글-정리처럼 이름을 붙여 실행하세요.
이전 대화에 그 이름이 붙어서 /resume으로 찾기 쉽습니다.
/compact 명령어는 대화 내역을 요약본으로 교체합니다.
같은 작업을 계속하지만 초반에 이것저것 찾아보던 과정까지 전부 가져갈 필요는 없을 때, 지나간 과정은 요약으로 압축하고 요점만 유지한 채 이어갑니다.
자동 압축(Autocompact)은 컨텍스트가 윈도우 끝에 가까워지면 시작됩니다.
윈도우에서 출력용 예약분(최대 2만 토큰)과 여유분(1.3만 토큰)을 뺀 지점이 기준이라, 1M 윈도우에서는 약 96.7만 토큰에서 압축이 시작됩니다.
Opus 5.5를 포함한 Opus 4.7 이후 모델과 Sonnet 5 이후 모델, Haiku 5.5, Fable 모델은 Pro를 포함한 모든 플랜에서 별도 설정 없이 1M 윈도우로 동작하며, [1m] 변형을 고르거나 1M을 위해 사용량 크레딧을 켤 필요도 없습니다./context 명령으로 현재 사용량을 직접 확인할 수 있으며, 결과에 표시되는 Context is 80% full 경고는 압축이 곧 시작된다는 예고일 뿐 실제 압축 시점이 아닙니다.
윈도우가 크다고 비용이 줄어드는 것은 아닙니다.
압축이 늦게 시작된다는 것은 그만큼 긴 대화가 매 턴 다시 전송된다는 뜻이기도 합니다.
트리거 시점을 앞당기려면 /autocompact 명령으로 자동 압축에 사용할 윈도우 크기를 지정합니다.
기본값 auto는 모델에 맞는 크기를 사용하며, /autocompact 300k(30만)처럼 10만에서 100만 사이의 토큰 값을 직접 전달할 수도 있습니다.
지정한 값은 사용자 설정에 모델별로 저장되어 다른 모델로 바꾸면 그 모델의 값이 적용되며(Claude Code v2.1.288 이상), 모든 모델에 같은 값을 적용하려면 설정 파일의 autoCompactWindow를 사용합니다.
특히 Haiku 5.5는 프롬프트가 10만 토큰을 넘는 요청부터 API 단가가 다섯 배로 오르므로, Haiku로 긴 세션을 이어간다면 압축 시점을 앞당기는 것이 유리합니다.
윈도우 크기 대신 퍼센트로 앞당기고 싶다면 CLAUDE_AUTOCOMPACT_PCT_OVERRIDE 환경 변수를 사용합니다.
기본값보다 높은 퍼센트는 무시되므로 앞당기는 용도로만 사용할 수 있습니다.
12345{ "env": { "CLAUDE_AUTOCOMPACT_PCT_OVERRIDE": "70" } }
/compact 뒤에 지시문을 붙이면 요약 방향을 제어할 수도 있습니다.
1/compact 인증 모듈과 현재 테스트 실패 사례 중심으로 요약
늘 같은 내용을 남기고 싶다면 프로젝트의 CLAUDE.md에 Compact instructions 절을 추가할 수도 있습니다.
123# Compact instructions 압축할 때는 결정된 내용, 수정한 파일 경로, 아직 실패하는 테스트를 남겨 주세요.
요약은 모델이 대화 전체를 읽는 작업이라서 압축 자체에도 비용이 듭니다.
자리를 오래 비울 예정이라면 그 전에 /compact를 실행하세요.
캐시가 살아 있을 때는 이전 대화를 캐시 가격으로 읽으면서 요약하지만, 캐시가 만료된 뒤에는 대화 전체를 정가로 다시 읽어야 합니다.
자세한 원리는 프롬프트 캐싱에서 다룹니다.
Pro와 Max 플랜에서는 한 시간 넘게 쉬었던 10만 토큰 이상의 세션을 이어가면, 첫 메시지를 보내기 전에 이어갈 방법을 묻는 대화상자가 열립니다.Resume from summary를 선택하면 곧바로 /compact를 실행해서 이후 요청에는 요약만 포함되고, Resume full session as-is를 선택하면 대화를 그대로 불러와 전체를 다시 캐시합니다.
어느 쪽이든 캐시는 이미 만료되었으므로 전체 대화를 한 번은 다시 읽지만, 이후 요청의 크기는 요약 쪽이 훨씬 작습니다.
입력하지 않는 동안 발생하는 턴도 세션 길이에 포함됩니다./loop로 등록한 반복 작업은 설정한 세션의 대화 전체를 실은 채 온전한 턴으로 실행되고, 마지막 턴 이후 캐시 수명이 지났다면 캐시 미스까지 더해집니다./goal로 목표를 설정한 세션이 백그라운드 작업을 기다리는 동안 진행 상황을 확인하는 턴(프롬프트 사이 최대 3번)과, 다른 세션에서 보낸 메시지를 전달받는 턴도 같은 방식으로 대화 전체를 전송합니다.
반복 작업은 다른 터미널에서 새 세션을 열어 실행하세요.
/btw(By The Way)는 대화 기록에 남길 필요가 없는 곁가지 질문을 던질 때 쓰는 슬래시 명령어입니다.
메시지 앞에 접두어로 붙이는 방식이 아니라 /btw 질문내용 형태로 사용합니다.
현재 컨텍스트는 참조하지만 도구 접근은 없고, 답변이 기록에 쌓이지 않아 이후 대화의 컨텍스트 크기에 영향을 주지 않습니다.
Claude가 작업 중인 동안에도 동시에 호출할 수 있다는 점이 유용합니다.
1/btw 그런데 이 모듈 이름은 무슨 뜻이야?
/rewind(또는 ESC 두 번)는 Claude가 잘못된 방향으로 갔을 때 특정 시점 직전으로 되돌리는 명령어입니다.
되돌릴 지점을 고른 다음, 메뉴에서 다음 옵션을 선택합니다.
Restore code and conversation: 코드와 대화를 모두 되돌림Restore conversation: 코드는 유지, 대화만 되돌림Restore code: 대화는 유지, 코드만 되돌림Summarize from here: 선택 지점부터 뒤쪽 대화를 요약으로 압축(컨텍스트 확보용)Summarize up to here: 선택 지점 앞쪽 대화를 요약으로 압축하고 이후 메시지는 그대로 유지Never mind: 되돌리지 않고 메뉴 닫기
선택한 지점 이후에 되돌릴 파일 변경이 없으면 코드 관련 두 항목은 메뉴에 나타나지 않습니다.
그리고 /compact와 달리 /rewind는 이미 캐시된 지점으로 돌아가는 것이라 프롬프트 캐시가 유지됩니다.
방향을 잘못 잡은 대화를 통째로 버리고 싶다면 /compact보다 /rewind가 유리합니다.
# 서브 에이전트
지금까지의 방법이 모두 컨텍스트에 덜 쌓이게 하는 방향이었다면, 서브에이전트(Subagent)는 쌓일 작업을 처음부터 다른 컨텍스트에서 처리하는 방법입니다.
서브에이전트는 메인 대화가 작업 하나를 분리해서 맡기는 별도의 Claude입니다.
자기만의 컨텍스트 윈도우에서 자체 시스템 프롬프트와 도구, 그리고 메인 대화가 읽은 CLAUDE.md를 가지고 시작하지만, 메인 대화 내용은 받지 않습니다.
기본으로 제공되는 Explore와 Plan 서브에이전트는 빠르고 저렴하게 탐색하도록 CLAUDE.md도 싣지 않습니다.
자체 턴을 실행하고, 작업이 끝나면 메인 대화로 돌아오는 것은 최종 답변 하나뿐입니다.
서브에이전트가 읽은 파일과 실행한 명령의 출력은 작업이 끝나는 순간 모두 폐기됩니다.
비용이 들지 않는 것은 아닙니다.
서브에이전트는 메인 대화를 모르기 때문에 메인에서 이미 읽은 파일을 다시 읽어야 할 수 있고, 그 턴의 토큰은 모두 요금에 포함됩니다.
메인 컨텍스트에 남지 않을 뿐이므로 작은 작업에는 오히려 손해입니다.
서브에이전트가 유리한 작업은 읽어야 할 양은 많은데 보관할 가치는 없는 작업입니다.
수천 줄짜리 로그 파일에서 오류 원인을 찾는 작업이 대표적인데, 메인에서 처리하면 수천 줄이 세션 끝까지 남지만 서브에이전트에게 맡기면 원인 한 줄만 남습니다.
Claude는 이런 성격의 작업을 만나면 스스로 서브에이전트를 사용하는 경우가 많고, 직접 시키고 싶을 때는 별도의 명령어 없이 요청에 적으면 됩니다.
1이 로그 파일은 서브에이전트로 검토해서 오류 원인만 알려 줘
메인 대화로 돌아오는 것은 서브에이전트가 보고하기로 선택한 내용뿐이라서, 작업 중에 발견한 것이라도 답변에 담지 않으면 과정과 함께 사라집니다.
맡길 때 무엇을 가지고 돌아올지 미리 지정하세요.
서브에이전트의 모델은 Claude가 호출할 때 지정한 모델, 정의 파일의 model, CLAUDE_CODE_SUBAGENT_MODEL 환경 변수, 메인 대화의 모델 순서로 정해집니다.
아무것도 지정하지 않으면 메인 대화와 같은 모델이라서, 기본값인 Opus 5.5로 작업하는 중이라면 서브에이전트도 Opus로 실행됩니다.
기본으로 제공되는 Explore도 메인 대화의 모델을 그대로 사용하므로, 같은 이름의 사용자 서브에이전트를 model: haiku로 정의하면 탐색을 Haiku로 실행할 수 있습니다.
반복해서 맡기는 작업이라면 서브에이전트 정의 파일에 model: haiku처럼 모델을 지정하며, haiku는 Claude Code v2.1.293부터 Haiku 5.5를 가리킵니다.
노력 수준도 정의 파일의 effort로 지정할 수 있고, v2.1.292부터는 Claude가 서브에이전트를 호출할 때 요청에 적은 노력 수준을 그대로 전달하므로 "서브에이전트를 low로 실행해 줘"처럼 요청할 수도 있습니다.
위임할 때 전달하는 지시만으로 충분한 작업이라면 omitClaudeMd: true를 추가해서 사용자와 프로젝트의 CLAUDE.md 없이 시작하게 할 수도 있습니다(Claude Code v2.1.271 이상).
12345678--- name: log-reader description: 로그 파일에서 오류 원인을 찾아 요약합니다 model: haiku omitClaudeMd: true --- 로그 파일을 읽고 오류의 원인과 발생 위치만 간단히 보고합니다.
# 프롬프트 캐싱
Claude는 반복되는 컨텍스트를 캐싱해 재사용 시점의 비용을 낮출 수 있는 프롬프트 캐싱(Prompt Caching)을 지원합니다.
Claude Code가 이 캐싱을 알아서 관리하지만, 실제로 비용을 줄이려면 두 가지를 짚고 넘어가야 합니다.
흔히 "캐싱은 90% 싸다"라고 알려져 있지만, 이는 캐시 Read(Cache Hit) 시점에만 해당합니다.
캐시 Write(Cache Miss)는 오히려 기본 입력(input) 가격보다 비쌉니다.
| 항목 | Input 비용 대비 |
|---|---|
| 5분 TTL 캐시 Write | 1.25배 |
| 1시간 TTL 캐시 Write | 2배 |
| 캐시 Read(Cache Hit / Refresh) | 0.1배 Opus 5.5와 Sonnet 5.5는 0.05배, Fable 5.1은 0.025배 |
즉, 캐시는 재사용이 실제로 일어나야 이득이 되는 구조입니다.
5분 TTL은 1회 Read부터, 1시간 TTL은 2회 Read부터 손익분기를 넘습니다.
Write는 토큰당 한 번이고 그 뒤의 모든 턴에서 Read가 반복되므로, 대화가 이어지는 일반적인 세션에서는 캐시가 이득입니다.
Anthropic은 Opus 5.5를 발표하면서 캐시 Read가 에이전트와 코딩 작업 비용의 대부분을 차지한다고 설명했고, 그래서 Opus 5.5의 캐시 Read 단가를 100만 토큰당 $0.20으로 낮췄습니다.
같은 이유로 2026년 10월 7일에는 Sonnet 5.5의 캐시 Read 단가도 $0.10으로 절반이 되었고, Anthropic은 이 인하로 대부분의 에이전트 작업에서 Sonnet 5.5의 비용이 약 20% 줄어든다고 설명했습니다.
한 턴의 청구는 이전 대화의 캐시 Read, 이번 턴에 새로 추가된 부분의 정가 입력, 그리고 응답의 출력 가격으로 구성됩니다.
수만 토큰이 들어가고 수백 토큰이 나오는 비대칭 구조라서, 새로 추가된 부분만 정가로 처리된다는 점이 중요합니다.
Claude Code는 요청 종류와 과금 방식에 따라 TTL을 다르게 요청합니다.
구독 요금제의 플랜 사용량 안에서 주고받는 메인 대화는 1시간 TTL을 사용하고, 서브에이전트나 워크플로우, 압축처럼 메인 대화 밖에서 이뤄지는 요청은 5분 TTL을 사용합니다.
플랜 한도를 넘겨 사용량 크레딧으로 과금되기 시작하면 메인 대화도 5분으로 내려가며, API 키나 클라우드 제공자로 연결한 경우에는 처음부터 5분입니다.
| 요청 종류 | 구독 플랜 사용량 이내 | 사용량 크레딧, API 키 |
|---|---|---|
| 메인 대화 | 1시간 | 5분 |
| 그 외(서브에이전트, 워크플로우, 압축 등) | 5분 | 5분 |
TTL을 직접 지정할 수도 있습니다.
메인 대화는 promptCacheTtl 설정이나 CLAUDE_CODE_PROMPT_CACHE_TTL 환경 변수로, 그 외 요청은 subagentPromptCacheTtl 설정이나 CLAUDE_CODE_SUBAGENT_PROMPT_CACHE_TTL 환경 변수로 지정하며, 값은 5m과 1h만 지정할 수 있습니다.
123{ "promptCacheTtl": "1h" }
캐시는 Hit될 때마다(즉, 캐시된 컨텍스트가 재사용될 때마다) TTL이 무료로 자동 갱신됩니다.
즉 연속 작업 중에는 캐시가 계속 살아있지만, TTL이 지나도록 캐시 Hit가 없으면 만료되고 다음 질문 시 쌓여 있던 토큰이 전부 Write 비용으로 재청구됩니다.
캐시가 실제로 얼마나 적중하는지는 앞서 본 /usage 화면의 Prompt cache (main) 줄에서 확인할 수 있습니다(Claude Code v2.1.251 이상).
요청 수, 캐시에서 읽은 입력 토큰 비율, 캐시 미스 횟수, 그리고 현재 캐시가 살아 있는지를 보여 주며, v2.1.260부터는 마지막 캐시 미스의 추정 원인도 함께 표시합니다.
캐시는 요청의 맨 앞부터 직전 요청과 비교해서 일치하는 구간까지만 재사용합니다.
요청은 항상 도구 정의가 포함된 시스템 프롬프트, CLAUDE.md와 메모리 같은 프로젝트 컨텍스트, 대화 순서로 조립됩니다.
대화 끝에 도구 결과 하나가 추가되는 것이 가장 이상적인 경우이고, 앞쪽이 바뀌면 그 뒤는 내용이 같더라도 전부 다시 계산됩니다.
캐시가 깨지는 동작은 모두 요청의 앞부분을 바꾸거나 캐시의 키를 바꾸는 동작입니다.
시간뿐만 아니라 세션 도중의 특정 동작도 캐시를 깨뜨립니다.
다음 동작들은 그다음 요청에서 대화 전체를 다시 읽게 만듭니다.
/model로 모델 바꾸기. 모델마다 캐시가 따로 있으며, 캐시가 살아 있는 동안에는 Claude Code가 바꾸기 전에 확인을 요청합니다.opusplan의 플랜 모드 전환과 스킬 프론트매터의model지정도 모델 전환입니다./effort로 노력 수준 바꾸기. 대부분의 모델은 단계마다 캐시가 따로 있고, Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1만 예외입니다./fast로 fast mode 켜기. 대화마다 처음 켤 때 한 번만 발생하며, 다시 계산도 fast mode 가격으로 이루어집니다. 끄거나 다시 켜는 것은 캐시에 영향을 주지 않습니다.- MCP 서버 연결이나 해제, MCP 서버가 포함된 플러그인 켜기와 끄기. 도구 정의가 지연 로드된 상태라면 캐시는 유지됩니다.
- 도구 검색이 동작하지 않는 환경에서
Bash처럼 도구 이름만 적어 도구 전체를 막는 거부 규칙 추가 /compact로 대화 압축. 대화 부분만 교체되므로 그 앞에 있는 시스템 프롬프트의 캐시는 유지됩니다.- 요청 한도에 닿을 만큼 이미지를 많이 첨부하기. Claude Code가 오래된 이미지를 한 묶음씩 빼면서 그 지점부터 다시 계산합니다.
- Claude Code 업데이트 뒤 처음 시작하는 대화. 시스템 프롬프트나 도구 정의가 바뀌어 처음부터 캐시를 만듭니다.
반대로 다음 동작들은 캐시를 유지합니다.
- 저장소의 파일 편집
- 세션 도중
CLAUDE.md편집. 대신 그 변경도 다음 세션에나 반영됩니다. - 권한 모드 전환
- 출력 스타일 바꾸기. 새 스타일은 대화 메시지로 전달되어 다음 메시지부터 적용됩니다.
- 스킬이나 슬래시 명령어 호출
/advisor켜기와 끄기/recap으로 요약 확인/rewind로 이전 지점으로 되돌리기- 서브에이전트 실행
--resume으로 이전 세션을 이어가는 것 자체는 캐시를 깨지 않습니다.
이어간 대화는 처음 시작할 때의 시스템 프롬프트를 그대로 유지하므로 캐시 수명 안이라면 그대로 적중하고, 대부분은 이미 캐시가 만료된 상태라서 다시 읽을 뿐입니다.
이 때문에, 일반적으로 "컨텍스트가 쌓이면 /compact로 주기적으로 정리해 관리하라"는 조언은 상황에 따라 틀릴 수 있습니다./compact 명령어는 대화 구조 자체를 교체하므로 대화 부분의 캐시가 무효화되고, 요약을 생성하는 비용도 추가되기 때문입니다.
캐시를 유지하기 위해서 다음과 같은 방식을 고려해 보세요.
- 모델과 노력 수준은 세션을 시작할 때나
/clear직후처럼 캐시가 비어 있을 때 정하고, 긴 대화 중간에는 바꾸지 않는다. Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1은 노력 수준을 바꿔도 캐시가 유지된다. - 자리를 오래 비우기 전에는
/compact를 실행한다. 캐시가 살아 있을 때 요약하는 것이 만료된 뒤에 전체를 다시 읽는 것보다 싸다. - 잘못된 방향으로 흘러간 대화는
/compact대신/rewind로 되돌린다. - 5분 TTL로 동작하는 환경이라면 5분 안에 호출이 계속 이어지도록 하거나, TTL을 1시간으로 직접 지정한다.
Claude API를 직접 호출할 때는 요청마다 cache_control로 TTL을 지정합니다.
12345678910111213// ... const client = new Anthropic() const response = await client.messages.create({ model: 'claude-opus-5-5', system: [ { type: 'text', text: largeContext, cache_control: { type: 'ephemeral', ttl: '1h' } } ], // ... })
# 마무리
Anthropic은 공식 블로그에서 세션 비용에 영향이 큰 요소를 다음 순서로 꼽습니다.
위에서 살펴본 방법을 이 순서로 정리했으니, 자신의 워크플로우에 맞는 조합을 찾아 Claude Code를 더 안정적으로 활용하세요.
- 긴 세션: 매 턴 대화 전체가 다시 전송되므로 세션에서 사용하는 토큰의 대부분이 여기서 소비됩니다. 새 작업은
/clear, 같은 작업의 다음 단계는/compact, 곁가지 질문은/btw, 잘못된 방향은/rewind로 세션을 짧고 가볍게 유지하고, 1M 윈도우에서는/autocompact로 압축 시점을 앞당길 수 있습니다. - 컨텍스트 과적: 필요 없던 파일, 명령 출력, 사용하지 않는 스킬과 MCP 서버가 매 턴 다시 전송됩니다. 파일은
@멘션으로 전달하고, 출력이 많은 명령에는 출력을 줄이는 옵션을 추가하고, 읽을 양이 많은 작업은 서브에이전트에게 맡깁니다. 새 세션에서는/context로 시작 상태를 확인하고,CLAUDE.md는 2천 토큰 이내로 유지하고,/skill-doctor와/mcp로 쓰지 않는 스킬과 서버를 정리하고, MCP보다 CLI 도구를 우선 사용합니다. - 과한 모델과 노력 수준: 다른 모든 비용이 여기에 곱해집니다. 기본 모델인 Opus 5.5를 모든 작업에 그대로 쓰지 말고
/model opusplan,/advisor로 모델을 분담하고,/effort로 노력 수준을 조절하되, 두 설정은 다음 세션에 이월되므로 새 세션에서 확인합니다. - 캐시를 깨는 행동: 대화 중간의 모델 변경, Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1을 제외한 모델의 노력 수준 변경, 캐시 수명보다 긴 공백은 대화 전체를 정가로 다시 계산하게 합니다. 설정 변경은 세션을 시작할 때 하고, 자리를 비우기 전에는
/compact를 실행하고, 과금 방식에 맞는 캐시 TTL을 확인합니다.
그리고 /usage와 /context 명령으로 현재 사용량과 캐시 적중률을 자주 확인하세요.
끝까지 읽어주셔서 감사합니다.
좋아요와 응원 댓글은 블로그 운영에 큰 힘이 됩니다!